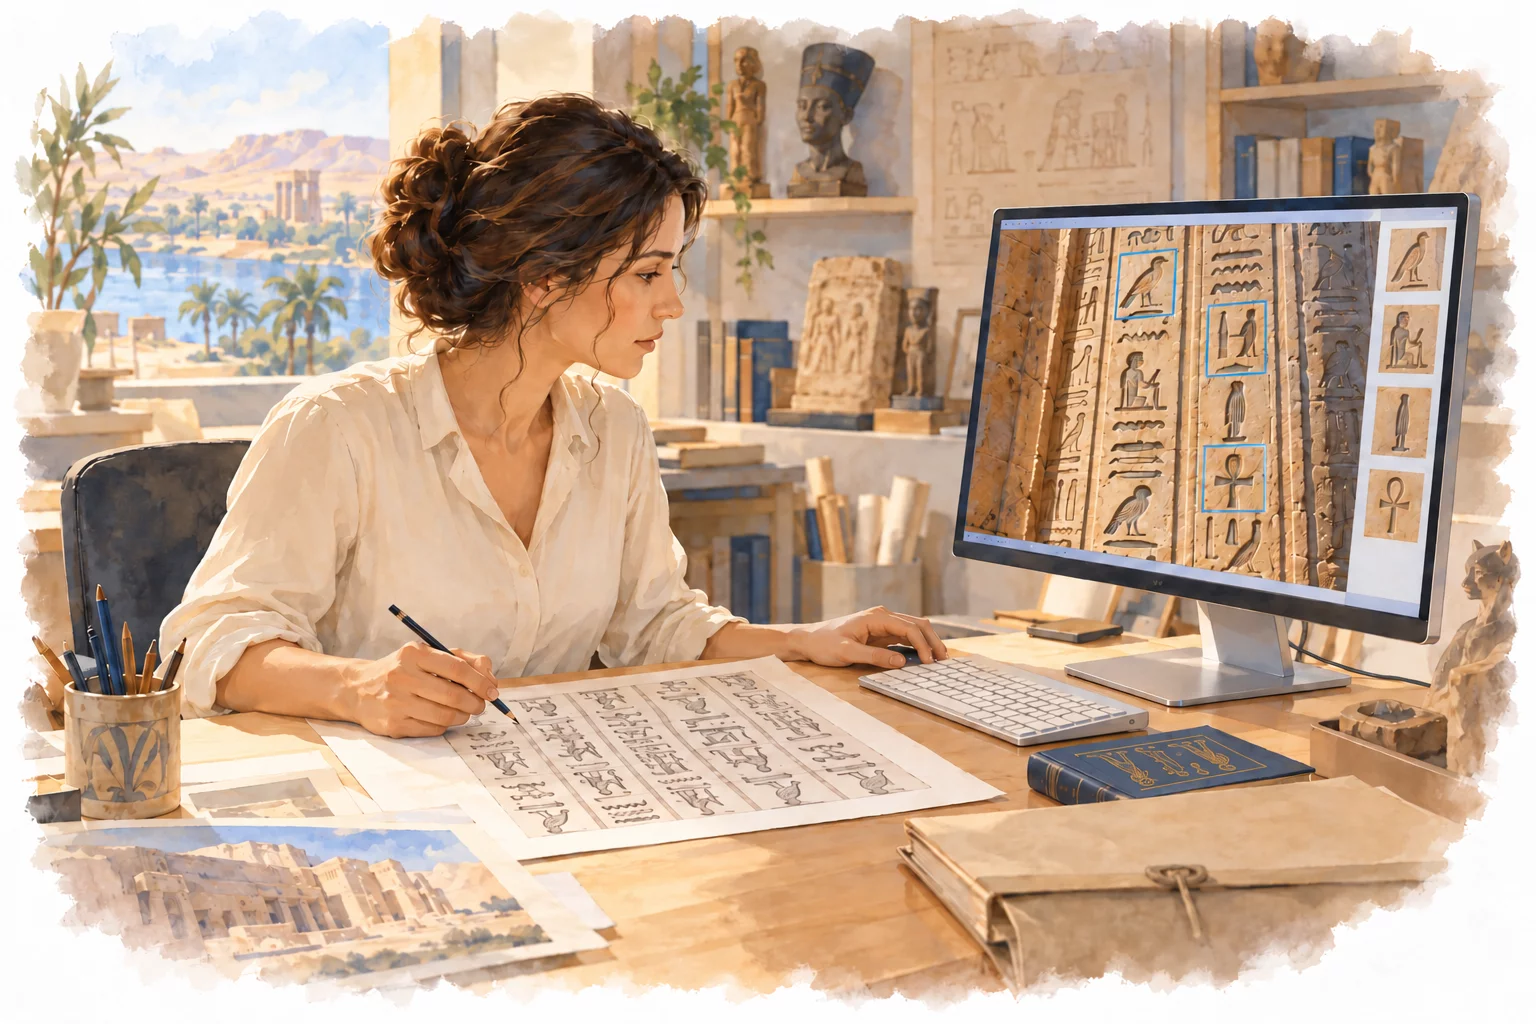
Les programmes de reconnaissance et de traduction des textes égyptiens utilisent les lectures, les dictionnaires et les corpus préparés par les chercheurs. Leurs résultats concernent des opérations précises : reconnaître une forme, proposer une valeur, comparer des témoins. Certains projets relient ces étapes dans une même interface. Pour apprécier leur apport, il faut savoir sur quels documents ils ont été évalués et ce que le lecteur peut encore vérifier ou corriger.
Les hiéroglyphes sont déchiffrés depuis 1822. L’intelligence artificielle intervient dans leur reconnaissance et leur interprétation à partir de connaissances déjà acquises. Certaines tâches ont donné des résultats mesurés ; d’autres restent des expériences ou des objectifs. Pour regarder ces progrès sans les réduire à une promesse, prenons le temps de distinguer les documents, les opérations et les équipes.
| Date | Jalon |
|---|---|
| 2013 | Premiers travaux de reconnaissance automatique des hiéroglyphes, sur les Textes des pyramides d’Ounas (Morris Franken et Jan van Gemert) |
| 2020 | Fabricius, outil de Google Arts & Culture conçu avec Ubisoft et l’université Macquarie |
| 2021 | Une équipe du CNR et de l’université de Florence classe les hiéroglyphes par réseaux de neurones, quel que soit le support |
| 2025 | Un système présenté à SIGGRAPH enchaîne reconnaissance, translittération et traduction |
Un point de méthode
Déchiffrer une écriture dont la clé a disparu et apprendre à traiter des textes déjà lus sont des travaux différents. Champollion a retrouvé le fonctionnement des hiéroglyphes. Les programmes actuels apprennent notamment à partir des lectures établies depuis sa découverte. Les dictionnaires, les grammaires et les corpus numériques leur donnent les exemples et les références nécessaires.
Le tri d’images et la recherche de ressemblances peuvent préparer l’examen de documents trop nombreux pour être comparés manuellement. Une première proposition de lecture peut aussi orienter le travail. Son utilité dépend de la possibilité de retrouver les signes concernés et les références qui la soutiennent.
Documents cités : La pierre de Rosette et la course au déchiffrement · L’ère numérique
Ce que l’IA sait faire aujourd’hui
En 2013, Morris Franken et Jan van Gemert étudient la reconnaissance automatique des hiéroglyphes sur des images des Textes des pyramides d’Ounas. En 2021, Andrea Barucci et ses collaborateurs du CNR et de l’université de Florence publient des travaux de classification de signes par réseaux de neurones, avec des images provenant de plusieurs supports. Ces recherches donnent des résultats sur des tâches délimitées, et leurs auteurs maintiennent la place du spécialiste dans la lecture.
Fabricius, lancé par Google Arts & Culture en 2020 avec Ubisoft et l’université Macquarie, propose également au public une initiation aux signes. En 2025, un système présenté à SIGGRAPH cherche à enchaîner reconnaissance, translittération et traduction. D’autres équipes examinent les lacunes, les variantes et les mains des scribes. Ces projets ne décrivent pas tous le même outil ; leurs résultats doivent être regardés séparément.
Documents cités : Les bâtisseurs de l’égyptologie
De la photographie à la traduction : plusieurs étapes
Une photographie contient des formes dont la reconnaissance peut être incertaine. Il faut ensuite retrouver l’ordre des signes, les mots et la construction de la phrase. Une erreur au départ peut modifier la translittération, puis la traduction. Le lecteur doit pouvoir remonter les étapes pour localiser la difficulté et reprendre la proposition.
L’étude de 2021 concerne le classement de signes isolés dans deux ensembles d’images. La diversité des supports ne démontre pas une lecture générale de toutes les inscriptions. OCR-PT-CT, présenté en prépublication en 2025 par David Fuentes-Jimenez et ses collaborateurs, dont Carlos Gracia Zamacona, travaille pour sa part sur des fac-similés de textes funéraires du Moyen Empire. Il convertit les signes reconnus en codes Gardiner et s’inscrit dans le travail de comparaison des témoins mené avec MORTEXVAR.
Le Hieroglyphic Transformer de Mattia De Cao, Nicola De Cao, Angelo Colonna et Alessandro Lenci, publié en 2024, apprend la traduction à partir de textes encodés issus d’un corpus préparé depuis le Thesaurus Linguae Aegyptiae. Il ne commence pas par la photographie de n’importe quel monument. THOTH.AI, conçu par So Miyagawa à Tsukuba, associe des ressources linguistiques à un modèle de langue. Son concepteur indique de meilleurs résultats avec les translittérations et le copte imprimé qu’avec des photographies de manuscrits anciens.
L’équipe présentée à SIGGRAPH 2025 réunit notamment Ilya Makarov et Ekaterina Aleksandrova avec Maksim Golyadkin, Innokentiy Humonen, Ianis Plevokas et Ekaterina Bureeva. Elle cherche à relier les opérations dans une même chaîne. Dans l’entretien publié en octobre 2025, les chercheurs expliquent que l’extension aux cursives exige de nouvelles données d’apprentissage. La cohérence d’une interface ne signifie pas que toutes ses étapes sont également fiables.
Documents cités : La publication du CNR · Présentation scientifique d’OCR-PT-CT · Publication du Hieroglyphic Transformer · Présentation et limites de THOTH.AI · Entretien avec l’équipe de SIGGRAPH · Présentation et étude de pyThoth, IJCAI 2026 · Présentation de la collaboration par Christ’s College, Cambridge · Publication de MEH · Publication de MuMMy · Étude de THOTH AI, NLP4DH 2025 · Étude sur l’alignement sémantique entre états de l’égyptien
2025–2026 : passer des démonstrations à un atelier de lecture
Dans pyThoth, présenté à IJCAI 2026 par Golyadkin, Humonen et Makarov, les signes reconnus et les annotations restent liés à l’image. Le chercheur peut corriger un signe, puis reprendre la translittération et la traduction. L’interface permet ainsi d’examiner les choix intermédiaires au lieu de recevoir seulement une phrase finale.
L’étude rapportée concerne huit participants, six étudiants en égyptologie et deux égyptologues doctorants, sur quatre extraits de fac-similés de stèles en moyen égyptien. Le temps total est de 51 minutes avec l’outil, contre 61 manuellement, soit un gain d’environ 16 %. Garder ces dimensions de l’expérience permet d’en apprécier le résultat sans l’étendre à tous les documents.
La collaboration présentée à CHI 2026 associe notamment Ekaterina Alexandrova et Alexandre A. Loktionov aux chercheurs en informatique. Les égyptologues participent à la définition des tâches et à leur évaluation. Leurs compétences interviennent donc dans la conception du dispositif, autant que dans la vérification des propositions.
Apprendre à lire des textes, au-delà des signes isolés
Un signe net dans une édition n’offre pas les mêmes difficultés que sa forme sur une pierre usée. MEH, Multisource Egyptian Hieroglyphs, présenté à ICCV 2025, rassemble des documents numériques, des scans et des photographies de monuments. Les annotations portent aussi sur l’organisation du texte. Des données synthétiques issues de séquences linguistiques servent à multiplier les exemples, avec la nécessité de vérifier ce qu’elles représentent des documents réels.
MuMMy, présenté à ACM Multimedia 2025, relie images, codes Gardiner, translittération et traduction anglaise à deux échelles de texte. Il permet d’examiner les effets d’une erreur d’une étape à l’autre. Pour le chercheur, pouvoir remonter de la traduction proposée au signe visible est indispensable : la phrase la plus fluide peut partir d’une mauvaise reconnaissance.
Donner aux modèles la connaissance des égyptologues
L’étude de THOTH AI publiée par So Miyagawa en 2025 fournit au modèle des ressources lexicales et morphologiques avant de lui demander une traduction. Cette approche, souvent appelée RAG, consiste à rechercher des informations pertinentes dans une base puis à les joindre à la demande. Le cas étudié est le décret de couronnement de Thoutmosis Ier. Les résultats encouragent l’emploi de connaissances linguistiques ciblées, sans démontrer une maîtrise de tous les textes égyptiens.
He Huang a proposé en mars 2026 un travail, indiqué comme accepté à LREC 2026, sur le rapprochement du sens des mots entre quatre états historiques de l’égyptien. La question est différente de celle du signe isolé : il s’agit de suivre une langue qui change pendant des millénaires. Les résultats annoncés restent limités. Leur intérêt devra se mesurer sur des comparaisons dont la pertinence philologique peut être expliquée.
Le vrai défi : les cursives
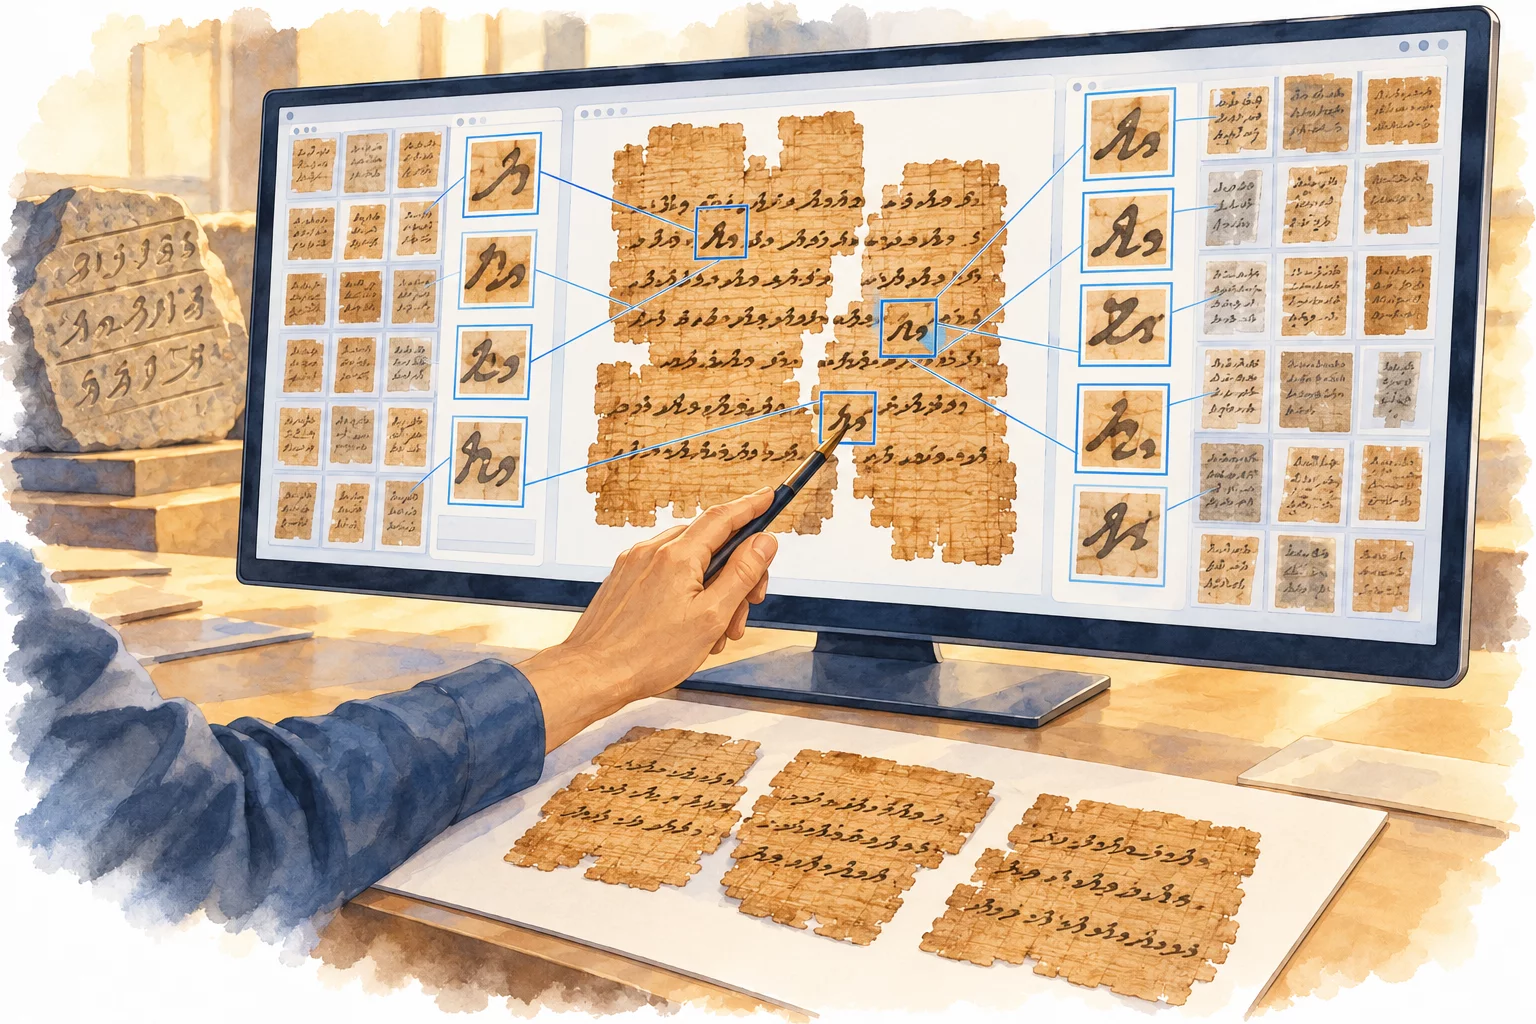
Le hiératique et le démotique obligent à reconnaître des ligatures, des variantes et des habitudes propres à une main. Une séparation entre deux signes peut être à peine visible. La période, le lieu et le scribe modifient encore les formes. Les difficultés sont considérables, même pour le lecteur formé ; les bons résultats obtenus sur des hiéroglyphes classiques ne peuvent pas être transposés directement.
Les papyrus et les ostraca encore à publier donnent un intérêt particulier à ces recherches. Leur étude demande cependant des exemples annotés avec précision, représentant plusieurs mains et états de conservation. Les corrections des spécialistes sont nécessaires pour préparer ces données et pour contrôler les lectures obtenues.
Documents cités : Les écritures du quotidien · Documentation de HieraticAI · Projet GlyPat · Présentation du projet AKU · Corpus SCAM et résultats des expériences · Objectifs et méthode de GlyPat
Des prototypes et des ressources pour les cursives
HieraticAI, développé par Margot Belot en 2025, expérimente la détection et la classification sur vingt lignes d’un fac-similé du papyrus Westcar. Une interface prévoit la validation par l’égyptologue. La modestie du corpus est importante pour comprendre ce que l’expérience établit et ce qu’il reste à éprouver sur d’autres mains.
À la Freie Universität Berlin, GlyPat, sous la responsabilité de Hubert Mara et avec notamment Margot Belot, Eren Kocadag et Philipp Schmidt, cherche des formules démotiques dans un corpus de 272 manuscrits annotés. La comparaison doit tenir compte des ligatures et des variantes. Ce travail de philologie informatique ne constitue pas un traducteur neuronal. Il peut orienter des rapprochements, tandis que les possibilités de datation ou de localisation demandent encore des tests.
AKU-PAL, issu du projet AKU à Mayence et Darmstadt, documente les formes cursives, leurs variantes et les contextes où elles sont attestées. Cette paléographie numérique permet de comparer les graphies et de préparer les annotations de futurs corpus d’apprentissage. Elle constitue une ressource savante, sans être elle-même un système de traduction automatique.
Le copte : prolonger la chaîne de l’écriture égyptienne
Le corpus SCAM, présenté à ICDAR 2026 par Fabio Quattrini, Carmine Zaccagnino, Costanza Bianchi, Silvia Cascianelli et Rita Cucchiara, concerne l’écriture manuscrite copte sahidique. Il réunit 3 240 lignes de vingt-sept feuillets d’un manuscrit du Monastère blanc daté de 1002–1003. Les images proviennent de conditions de numérisation différentes.
Dans ces expériences, le passage d’un ensemble d’images à un autre pose des difficultés, alors qu’il s’agit du même manuscrit. Les conditions de numérisation influent donc sur les résultats. Le corpus permet d’étudier cette variation sur un document copte médiéval bien identifié.
Pour les cursives plus anciennes, GlyPat envisage une recherche interactive où les variantes restent accompagnées de leurs images. À terme, les rapprochements pourraient aider à situer des manuscrits, si l’on démontre ce que les ressemblances disent réellement de leur histoire. C’est un objectif, à distinguer d’une capacité déjà acquise.
Restituer les lacunes et mieux comprendre les textes
Quand un passage manque, un autre témoin peut conserver la formule. HieroLM, proposé en 2025 par Xuheng Cai et Erica Zhang, examine la prédiction de signes absents à partir du contexte. Une proposition demande ensuite à être confrontée aux traces, à la grammaire et aux passages parallèles. Elle doit rester signalée comme restitution.
Ithaca, pour les inscriptions grecques, et Aeneas, présenté en 2025 pour les inscriptions latines, explorent d’autres rapprochements entre texte, contexte et données visuelles. Les travaux auxquels participent Yannis Assael et Thea Sommerschield donnent des pistes de méthode. Leur adaptation à l’égyptien exigerait des corpus et des évaluations propres à cette langue.
Les rapprochements de formules peuvent orienter l’étude de leur transmission, de leurs variantes ou de leur circulation entre des milieux de scribes. Il faut ensuite comparer les dates, les provenances et les emplois des textes. La ressemblance calculée ne fournit pas à elle seule cette explication historique.
Documents cités : Publication de HieroLM
Lire sans dérouler : le rôle de l’imagerie
Le Vesuvius Challenge prolonge les travaux de Brent Seales sur les rouleaux carbonisés d’Herculanum. La tomographie et le déroulement virtuel permettent d’examiner les volumes ; l’apprentissage automatique contribue à repérer l’encre. Les papyrologues lisent ensuite les textes rendus visibles.
Cet exemple italien ouvre des perspectives pour des documents fragiles. Il repose toutefois sur une trace physique mesurable et sur une imagerie adaptée au matériau. Une image générée qui ressemble à un texte ancien ne restitue pas, à elle seule, les mots perdus d’un rouleau.
Documents cités : Programme Vesuvius Challenge · Étude sur le cercueil et l’imagerie hyperspectrale
Retrouver les traces avant de les interpréter
En Égypte, une étude de 2024 associant notamment Costanza Cucci, Andrea Barucci et Fabrizio Argenti porte sur une inscription dégradée d’un cercueil de la XXVe dynastie. L’imagerie hyperspectrale mesure la réponse de la surface dans le visible et le proche infrarouge. Des traitements distinguent mieux certaines traces, puis des réseaux de neurones contribuent à segmenter les signes.
Cette étude améliore l’observation de traces conservées sur le cercueil avant leur lecture. Les mesures, les images traitées et les décisions de segmentation doivent être conservées avec les interprétations. D’autres chercheurs pourront ainsi examiner les mêmes indices et discuter les valeurs attribuées aux signes.
De nouvelles datations, à quelles conditions ?
Le projet Enoch, porté notamment par Mladen Popović, Maruf A. Dhali et Lambert Schomaker à Groningen, associe en 2025 datations radiocarbone et analyse des formes de l’écriture des manuscrits de la mer Morte. Entraîné sur vingt-quatre manuscrits datés au carbone 14, le modèle propose des datations pour 135 autres, confrontées ensuite à un examen paléographique. Certains résultats suggèrent des dates plus anciennes qu’on ne l’envisageait.
Cela concerne ce corpus. Une application à l’égyptologie demanderait des références indépendamment datées et représentatives. Reconnaître une main, dater la copie d’un document et dater la composition du texte qu’il conserve sont des questions distinctes. Une photographie ne donne pas à un programme la mesure de l’âge d’un monument.
Documents cités : Étude publiée dans PLOS One · Programme de Bâle et publications
Des papyrus d’Égypte comme terrain de datation
À Bâle, Isabelle Marthot-Santaniello travaille avec des chercheurs en analyse de données sur les papyrus grecs d’Égypte. La comparaison visuelle, le rapprochement de documents et l’étude des mains font partie de ces recherches, avec les ressources NeuroPapyri et Hell-Date. Papy-Date, corpus de papyrus grecs datés à l’année, figure parmi les contributions annoncées pour l’atelier de paléographie informatique d’ICDAR 2026.
Ces documents appartiennent à l’histoire de l’Égypte gréco-romaine. Leurs résultats ne peuvent pas être étendus sans évaluation au hiératique et au démotique. Ils montrent en revanche comment une question historique peut orienter la construction d’un corpus et d’un outil de comparaison.
Reconstituer les monuments et rapprocher les fragments
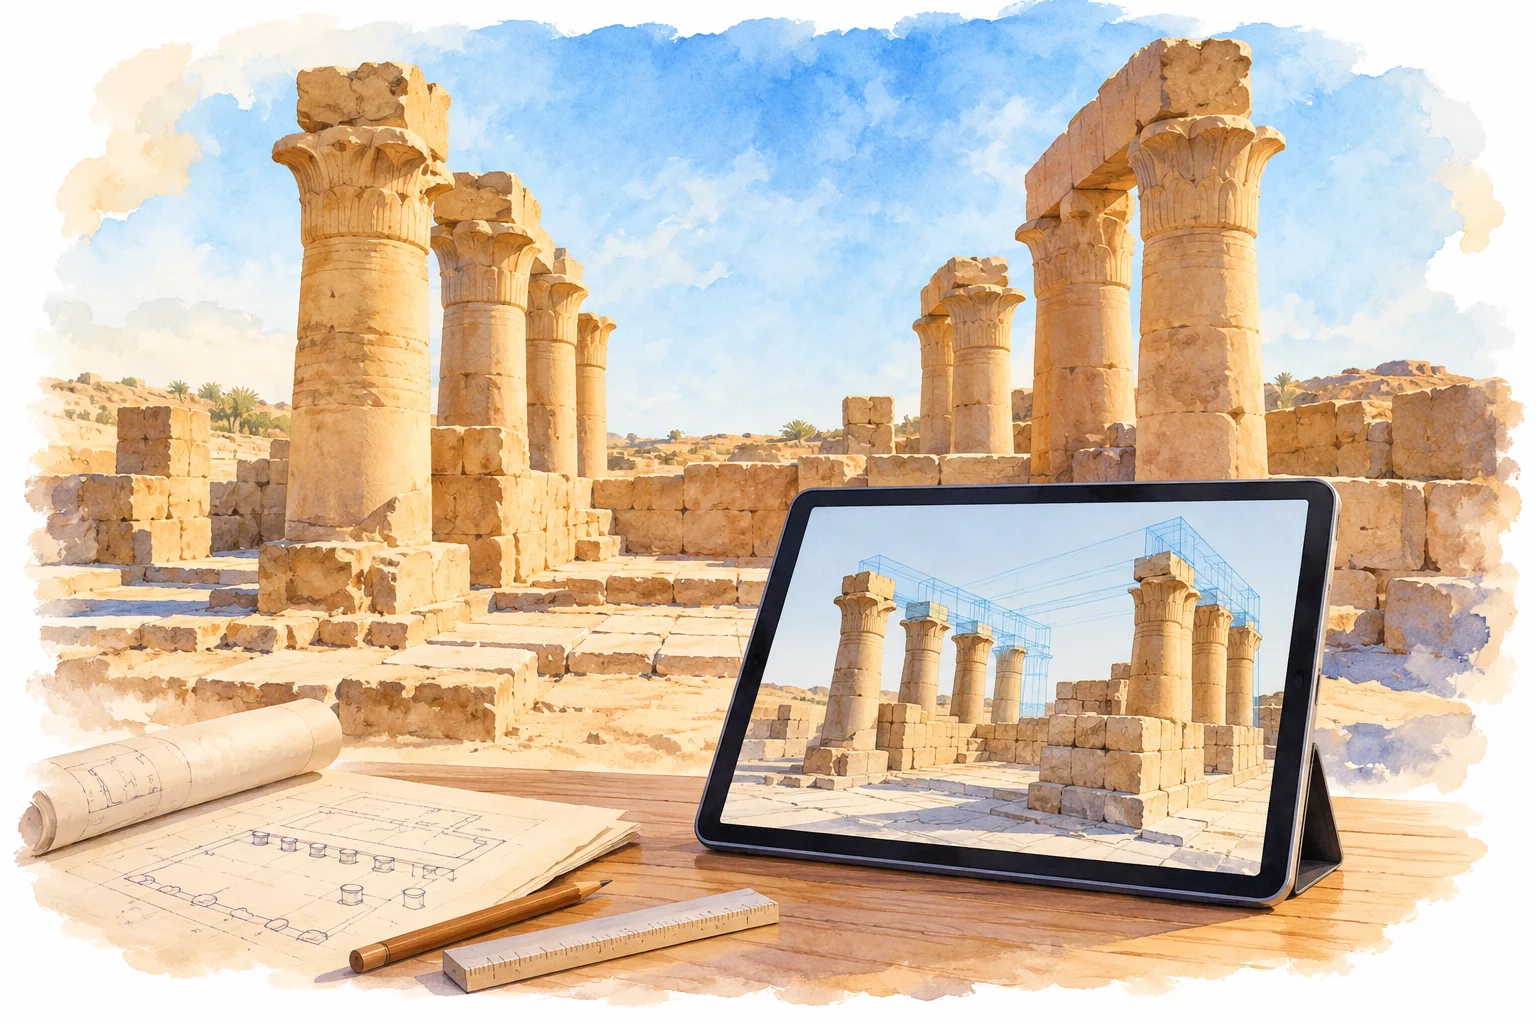
Avant de produire une restitution, il faut des plans, des mesures, des photographies et des archives. Digital Giza, dirigé à Harvard par Peter Der Manuelian, rassemble ces documents et des modèles du plateau de Gizeh. La modélisation numérique ne repose pas nécessairement sur l’IA. Elle fournit d’abord une organisation de ce que nous savons et de ce qui reste hypothétique.
RePAIR, coordonné à Ca’ Foscari et associé à Marcello Pelillo, a expérimenté à Pompéi la recherche de raccords entre fragments de fresques par numérisation 3D et IA, puis leur disposition par robotique. Les conservateurs et les archéologues interviennent pour valider les assemblages. Le projet PERCEIVE explore, entre autres, l’IA et les expériences immersives pour le patrimoine coloré.
Pour les couleurs, une restitution doit indiquer ce qui provient de pigments observés, de comparaisons et d’hypothèses. Les modèles peuvent présenter plusieurs états possibles d’un décor. Leur réalisme visuel ne permet pas de décider lequel correspond au monument ancien.
Documents cités : Présentation de Digital Giza · Bilan scientifique de RePAIR · Programme PERCEIVE · Bilan et perspectives d’ARCHER, 2026 · Résultats et perspectives de RePAIR · Annonce officielle de l’université de York
Recomposer un monument : apprendre des formes et garder les preuves
Le bilan d’ARCHER publié en juin 2026 présente des expériences de restitution architecturale en deux et trois dimensions, notamment sur des temples grecs et des églises romanes et mudéjares, avec des corpus synthétiques. Elles explorent la restitution de parties manquantes et la préparation de modèles documentés. Ce terrain demeure différent de celui d’un temple égyptien.
Le bilan final de RePAIR, publié par Ca’ Foscari en décembre 2025, décrit un prototype utilisant deux bras robotiques pour disposer des fragments de fresques de Pompéi. Il aide à préciser les gestes que l’on peut assister et les vérifications qui restent à accomplir. Pour les collections égyptiennes, la comparaison de grands ensembles fragmentaires serait une piste à tester sur leurs matériaux et leurs décors.
2026 : un centre dédié à l’IA et au patrimoine égyptien
Le British Egyptian Centre of AI and Virtual Heritage, BECAIVE, est inauguré au Caire le 17 août 2026. L’université de York et le NRIAG le portent conjointement, sous la direction de Mohamed Gamal Abdelmonem et Abbas Ali. Le programme associe équipements, formation et recherche, avec notamment l’objectif de rapprocher les sites des objets conservés dans des musées éloignés. Des visites virtuelles de Hawara accompagnent son lancement.
Le centre réunit des moyens de formation et de recherche autour du patrimoine égyptien. Les applications annoncées restent des objectifs dont il faudra examiner les résultats. Son inauguration constitue une étape institutionnelle, distincte de l’évaluation des outils qui y seront développés.
Des archives de fouilles aux paysages archéologiques
L’IFAO et TEKLIA ont travaillé sur quatre carnets de Bernard Bruyère, soit 891 pages de notes et de dessins liés aux fouilles de Deir el-Médineh. La reconnaissance manuscrite et l’indexation facilitent l’accès aux observations de l’archéologue. Ici, la machine lit une écriture française du XXe siècle. Le gain peut pourtant concerner l’histoire ancienne, lorsque ces notes sont rapprochées des objets et de leur contexte de découverte.
ArchAIDE, coordonné par l’université de Pise, étudie la description et la comparaison des tessons avec des catalogues de céramiques. Les catégories présentes dans les données limitent ce que l’outil peut proposer. Un spécialiste doit revenir aux objets.
À une autre échelle, l’université de Yamagata et IBM ont utilisé la détection assistée sur des images du paysage de Nazca, au Pérou. Leur publication de 2024 rapporte une campagne ayant confirmé 303 nouveaux géoglyphes en six mois. L’exemple montre ce que peut apporter un repérage informatique suivi d’une vérification sur le terrain ; il ne décrit pas une découverte égyptienne.
Documents cités : Travail TEKLIA–IFAO · Projet ArchAIDE · Résultats de l’équipe Yamagata–IBM
Les projets de demain : relier les textes, les objets et les lieux
PAMELA, programme européen coordonné par l’université Charles de Prague, est annoncé du 1er janvier 2026 au 31 décembre 2029. Il associe papyrus grecs, manuscrits médiévaux, paléographie assistée, analyses matérielles non invasives et reconstruction numérique. Les ressources, les méthodes communes et la formation font partie de ses objectifs.
Ces objectifs permettent d’envisager les usages suivants. Ils ne constituent pas un calendrier de découvertes ni la description d’un logiciel déjà disponible.
Documents cités : Objectifs et calendrier de PAMELA, Commission européenne
Un dossier de lecture que l’on puisse reprendre
Un dossier pourrait réunir la photographie, la position des signes, les lectures envisagées et les parallèles consultés. Les corrections seraient enregistrées avec leurs raisons. Un autre lecteur disposerait alors des éléments nécessaires pour reprendre la traduction et comprendre les choix précédents.
Des fragments et des collections remis en relation
La comparaison de collections dispersées pourrait aider à retrouver des fragments liés ou à rapprocher un objet de ses archives de fouille. Les raccords proposés devraient être contrôlés sur les matériaux, les dimensions, les décors et les textes. Les suggestions permettraient d’orienter l’examen, sans tenir lieu de preuves.
Des hypothèses historiques mieux confrontées
La recherche de variantes entre plusieurs témoins pourrait faciliter l’étude d’une formule, d’une main ou d’un récit. Les correspondances et les divergences resteraient consultables avec les images des documents. Leur interprétation demanderait de confronter les contextes plutôt que de retenir automatiquement le rapprochement le plus fréquent.
Une transmission accessible, jusque dans ses incertitudes
Les mêmes dossiers pourraient servir à l’enseignement. Un étudiant comparerait plusieurs lectures et leurs justifications ; un visiteur pourrait suivre le passage d’une trace visible à un mot traduit. Les restitutions de monuments indiqueraient les éléments documentés et ceux qui restent discutés.
Les limites
Une proposition bien formulée peut être fausse. Les modèles apprennent dans des corpus où certaines périodes, certains genres et certaines formules sont mieux représentés que d’autres. Leur aisance sur un cas fréquent peut masquer leurs difficultés devant un document rare.
Pour évaluer un outil, il faut connaître les exemples d’apprentissage, les documents de test et la tâche effectivement mesurée. Classer un signe, traduire une phrase et comprendre son usage historique ne demandent pas les mêmes vérifications. Les images et les transcriptions contrôlées doivent rester consultables.
Le spécialiste peut aussi juger qu’un passage reste illisible ou que plusieurs interprétations demeurent possibles. Les outils devraient permettre de conserver cette incertitude, sans imposer une réponse simplement parce que leur interface attend un résultat.
Documents cités : Étude de reproductibilité, NLP4DH 2026
Mesurer les progrès pour les rendre durables
En juillet 2026, Ammar Toutou, Abdelrahman Harb et Christine Basta examinent un système de traduction de l’égyptien vers l’allemand. Sur cinquante traductions du jeu de test, seize figurent déjà à l’identique dans les données d’apprentissage. La répétition des formules anciennes peut ainsi favoriser une mémorisation et gonfler certains résultats.
Les auteurs proposent un jeu de test nettoyé et de nouvelles références de comparaison. Ces évaluations portent sur les performances du système, pas sur un pourcentage de traductions historiquement exactes. Écarter les exemples déjà présents dans l’apprentissage permet de mieux mesurer le travail sur des documents nouveaux.
De Thot à l’IA
Dans le Phèdre, Thamous reproche à l’écriture de donner aux hommes une apparence de savoir. Les traductions proposées par les machines posent à leur tour la question de ce que nous comprenons réellement du texte obtenu. Une phrase lisible peut nous satisfaire avant même que nous ayons examiné les signes qui la justifient.
Les exemples de cette série vont des étiquettes d’Abydos aux lettres sur ostraca, des inscriptions des temples aux notes des archéologues. Chaque document demande une méthode adaptée. Les outils actuels peuvent aider à les rapprocher, à rendre des traces plus visibles et à préparer leur lecture. Ils utilisent pour cela un savoir construit par des générations de chercheurs.
Ce travail continue avec de nouvelles images, des transcriptions corrigées et des interprétations discutées. Conserver ces étapes permet à d’autres de reprendre l’enquête. La mémoire de l’Égypte tient aussi à cette possibilité de revenir aux documents, au lieu de laisser une traduction achevée faire oublier les questions qui restent ouvertes.
Documents cités : Le Verbe et le calame · Treize siècles d’erreurs
Sources
- Morris Franken et Jan C. van Gemert, « Automatic Egyptian hieroglyph recognition by retrieving images as texts », Proceedings of the 21st ACM International Conference on Multimedia, 2013.
- Andrea Barucci et al., « A Deep Learning Approach to Ancient Egyptian Hieroglyphs Classification », IEEE Access 9, 2021.
- Google Arts & Culture, Fabricius, 2020.
- SIGGRAPH Blog, « AI and Ancient Egyptian Texts », 2025.
- Platon, Phèdre, 274c-275b.